突破記憶體牆瓶頸 AI晶片產業加速邁向「記憶體解耦」新架構
鉅亨網新聞中心
 AI新聞摘要
- 1.半導體巨頭達成記憶體解耦共識,評估指標由純算力轉為每瓦與每美元代幣數。
- 2.高通發表 3D 堆疊 HBC 方案,SK 海力士則推出 PIM 與 HBF 等分層記憶體架構。
- 3.系統整合與部署速度成關鍵,AWS 透過同地測試大幅縮短晶片驗證周期。
2026 年 AI 基礎設施峰會於加州聖克拉拉舉行,吸引約 6,000 人參與。包括美光(MU-US)、三星、SK 海力士(SKHY-US)、博通(AVGO-US)、高通(QCOM-US)、OpenAI 與 AWS 等半導體及雲端巨頭聚首,對記憶體與儲存架構的「分層解耦」(Memory-Storage Disaggregation)達成強烈共識,視其為打破「記憶體牆」(Memory Wall)瓶頸的最可行技術路徑。
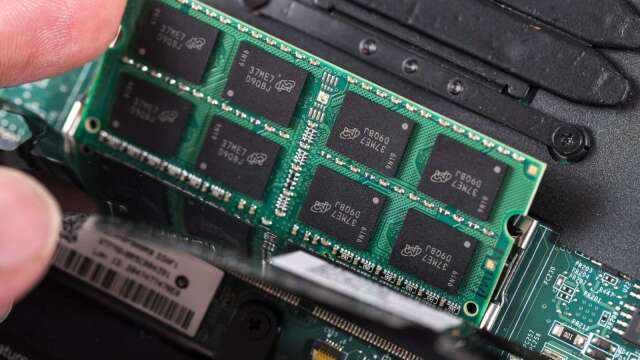
記憶體解耦是指將傳統以 GPU 為中心、依賴單一高效能記憶體的架構,轉變為將記憶體與儲存進行「分層」與「專用化」分離的系統設計。其核心思維是「動態分層、按需配置」,打破過往只靠單一高效能記憶體(如 HBM)支撐所有運算的做法,改依不同工作負載選用最合適的記憶體層級。
評估指標轉向:效率優先取代純算力堆疊
數據顯示,Transformer 模型規模每兩年暴增約 240 倍,但記憶體頻寬與容量同期僅成長約 2 倍,導致傳統以 GPU 為中心的架構難以為繼。
美銀證券研究團隊於報告中指出,隨著 AI 應用走向代理人 AI(Agentic AI),產業的評估架構已由追求純粹算力(FLOPs),全面轉向「每瓦代幣數」(tokens/W)與「每美元代幣數」(tokens/$)等效率指標。這使資料中心的採購邏輯發生實質改變,記憶體架構的靈活性與能源效率成為全新競爭維度。
廠商技術路線分化:3D 堆疊與分層記憶體
面對多樣化工作負載,各大廠商相繼發表創新技術:
高通發表「HBC」(高頻寬計算)方案,將 LPDDR 記憶體直接 3D 堆疊於計算晶片上,達到 SRAM 約 200 倍的容量功耗比與 HBM 約 6 倍的頻寬功耗比,預計於 2027 年年中的 AI250 加速卡首次亮相。
SK 海力士推出情境化分層記憶體,包含專為記憶體密集負載打造的 PIM(記憶體內運算)、專攻長文本且容量達 HBM 10 倍的 HBF(高頻寬快閃記憶體),以及 SALT-KV 軟體調度方案。
博通、Marvell 與 Astera Labs:在互連層面,博通推動全層級開放乙太網路架構;Marvell 與 Astera Labs 則提供客製化晶片與專用 PCIe 方案,回應熱絡的客製化需求。
部署速度與系統級整合成為關鍵
除了晶片設計,機架量產與部署穩定度也成為重要焦點。AWS 的實務經驗顯示,透過將測試產能與部署現場同地建置,成功大幅壓縮原本長達 6 至 9 個月的晶片測試穩定周期。
美銀證券團隊總結,產品的快速迭代不再單靠晶片設計能力,更取決於系統級工程整合與軟硬體協同優化。
- 原物料行情 正面臨哪些關鍵轉折?
- 掌握全球財經資訊點我下載APP
延伸閱讀
- 補丁科16日以740元登興櫃 AI記憶體權利金明年起貢獻
- 三星端AI記憶體新藍圖!HBM5性能翻倍、zHBM狂飆8倍
- 三星揭下一代記憶體路線圖:HBM5效能拚HBM4E 2倍、zHBM更達8倍
- 三星拋出HBM三階段路線圖:從「騰空間」到3D zHBM消滅中介層 終極架構將降功耗70%、頻寬飆230%

- 講座
- 公告
上一篇
下一篇